Bienvenidos a una nueva entrega en el maravilloso mundo de las redes en AWS.
Muchos arquitectos caen en la trampa de desplegar un NAT Gateway solo para que sus servidores privados se comuniquen con servicios como Amazon S3 y DynamoDB. Esto no solo infla la factura, sino que puede resultar contraproducente si nuestro objetivo es mantener los recursos 100% aislados del mundo exterior. Por eso, hoy vamos a construir una arquitectura de conectividad privada, segura y, lo mejor de todo, con un costo de red de $0.
Es posible tener lo mejor de ambos mundos: seguridad extrema y ahorro total?
Arquitectura base
Para que este workshop sea fluido y nos enfoquemos en lo que realmente importa asegurar la conectividad privada entre nuestros servidores y servicios como S3 y DynamoDB he diseñado una plantilla de CloudFormation. Con ella, podrás desplegar en minutos la infraestructura base que incluye:
-
VPC: Una red virtual aislada con una subred 100% privada (sin Internet Gateway).
-
Tabla de Rutas: Asociada específicamente a nuestra subred privada.
-
Instancia EC2: Un servidor sin dirección IP pública (totalmente invisible desde internet).
-
Recursos de Datos: Un Bucket de Amazon S3 y una Tabla de Amazon DynamoDB listos para ser consumidos.
-
Seguridad IAM: Un rol con el principio de mínimos privilegios para interactuar con S3 y DynamoDB de forma segura.
-
Security Group: Configurado específicamente para nuestra instancia EC2.
💡 Nota de Arquitecto: Al no tener un Internet Gateway, nuestra instancia nace “ciega y sorda” hacia el exterior. Es el escenario perfecto para probar cómo los VPC Endpoints actúan como túneles privados dentro de la red global de AWS.
💡 Nota: Si te apasionan las redes y prefieres construir cada componente desde cero, en mi perfil de dev.to tengo exactamente lo que necesitas. He preparado dos workshops previos donde te explico paso a paso cómo crear una VPC, subredes, tablas de rutas y mucho más:
Si ya lo tienes controlado, crea el stack con la plantilla que preparé para ti y te dejo a continuación.
AWSTemplateFormatVersion: '2010-09-09'
Description: 'Workshop Base: Red Privada Aislada para Práctica de VPC Endpoints'

Parameters:
  VpcCIDR:
    Type: String
    Default: 10.0.0.0/24
    Description: CIDR para la VPC del Workshop

  PrivateSubnetCIDR:
    Type: String
    Default: 10.0.0.0/25
    Description: CIDR para la Subred Privada (128 IPs)

  LatestImageId:
    Type: 'AWS::SSM::Parameter::Value<AWS::EC2::Image::Id>'
    Default: '/aws/service/ami-amazon-linux-latest/al2023-ami-kernel-6.1-x86_64'


Resources:
  # --- INFRAESTRUCTURA DE RED ---
  VPC:
    Type: AWS::EC2::VPC
    Properties:
      CidrBlock:
        Ref: VpcCIDR
      EnableDnsSupport: true
      EnableDnsHostnames: true
      Tags:
        - Key: Name
          Value: Workshop-VPC-Endpoint

  PrivateSubnet:
    Type: AWS::EC2::Subnet
    Properties:
      VpcId:
        Ref: VPC
      CidrBlock:
        Ref: PrivateSubnetCIDR
      AvailabilityZone:
        Fn::Select:
          - 0
          - Fn::GetAZs: ""
      MapPublicIpOnLaunch: false # Crucial: Asegura que ningun recurso se lance con ip publica
      Tags:
        - Key: Name
          Value: Subred-Aislada

  PrivateRouteTable:
    Type: AWS::EC2::RouteTable
    Properties:
      VpcId:
        Ref: VPC
      Tags:
        - Key: Name
          Value: Tabla-Ruteo-Privada

  SubnetRouteTableAssociation:
    Type: AWS::EC2::SubnetRouteTableAssociation
    Properties:
      SubnetId:
        Ref: PrivateSubnet
      RouteTableId:
        Ref: PrivateRouteTable

  # --- SEGURIDAD (IAM) ---
  EC2InstanceRole:
    Type: AWS::IAM::Role
    Properties:
      AssumeRolePolicyDocument:
        Version: '2012-10-17'
        Statement:
          - Effect: Allow
            Principal:
              Service: [ec2.amazonaws.com]
            Action: ['sts:AssumeRole']
      ManagedPolicyArns:
        - arn:aws:iam::aws:policy/AmazonS3ReadOnlyAccess
        - arn:aws:iam::aws:policy/AmazonDynamoDBReadOnlyAccess
      Policies:
        - PolicyName: EC2ConnectPolicy
          PolicyDocument:
            Version: '2012-10-17'
            Statement:
              - Effect: Allow
                Action:
                  - ec2-instance-connect:SendSSHPublicKey
                Resource:
                  Fn::Sub: "arn:${AWS::Partition}:ec2:${AWS::Region}:${AWS::AccountId}:instance/*"

  EC2InstanceProfile:
    Type: AWS::IAM::InstanceProfile
    Properties:
      Roles:
       - Ref: EC2InstanceRole

  # --- SEGURIDAD (Security Groups) ---
  InstanceSecurityGroup:
    Type: AWS::EC2::SecurityGroup
    Properties:
      GroupDescription: Permite SSH solo desde el CIDR de la VPC (temporalmente)
      VpcId:
        Ref: VPC
      SecurityGroupIngress:
        - IpProtocol: tcp
          FromPort: 22
          ToPort: 22
          CidrIp:
            Ref: VpcCIDR # Permitimos traficos desde la red interna

  # --- CÓMPUTO ---
  WorkshopInstance:
    Type: AWS::EC2::Instance
    Properties:
      InstanceType: t3.micro
      IamInstanceProfile:
        Ref: EC2InstanceProfile
      ImageId:
        Ref: LatestImageId
      SubnetId:
        Ref: PrivateSubnet
      SecurityGroupIds:
        - Ref: InstanceSecurityGroup
      Tags:
        - Key: Name
          Value: EC2-Privada-Workshop

  # --- RECURSOS DE DATOS (Para las pruebas) ---
  WorkshopBucket:
    Type: AWS::S3::Bucket
    Properties:
      BucketName:
        Fn::Sub: 'workshop-s3-endpoint-${AWS::AccountId}-${AWS::Region}'
      PublicAccessBlockConfiguration:
        BlockPublicAcls: true
        BlockPublicPolicy: true
        IgnorePublicAcls: true
        RestrictPublicBuckets: true

  WorkshopTable:
    Type: AWS::DynamoDB::Table
    DeletionPolicy: Delete
    Properties:
      TableName: Workshop-Dynamo-Endpoint
      AttributeDefinitions:
        - AttributeName: ID
          AttributeType: S
      KeySchema:
        - AttributeName: ID
          KeyType: HASH
      BillingMode: PAY_PER_REQUEST

Outputs:
  VpcId:
    Value:
      Ref: VPC
  SubnetId:
    Value:
      Ref: PrivateSubnet
  RouteTableId:
    Value:
      Ref: PrivateRouteTable
  BucketName:
    Value:
      Ref: WorkshopBucket
🚀 Despliegue de la infraestructura
Esta plantilla está diseñada para que la puedas desplegar en cualquier región. Yo personalmente estaré trabajando en Ohio (us-east-2); ya saben, para no estar tan “amorochados” en Virginia con el resto del mundo 😉.
Para lanzar el laboratorio, sigue estos pasos:
-
Copia el código YAML de arriba y guárdalo en tu editor favorito con el nombre base-stack.yaml.
-
Ve a la consola de AWS CloudFormation y selecciona Create stack > With new resources (standard).
-
En la sección de Template source, elige Upload a template file y sube tu archivo.
-
Asigna un nombre al stack (ej. Workshop-VPC-Endpoints) y deja los parámetros por defecto.
-
Haz clic en Next hasta llegar al final, marca la casilla de “I acknowledge that AWS CloudFormation might create IAM resources” y presiona Submit.
Al finalizar la creación (después de unos 2 o 3 minutos), deberías ver el estado como: CREATE_COMPLETE.

Plan de batalla 🎯.
Para conquistar este laboratorio, nos dividiremos en tres objetivos estratégicos:
-
Misión 1: El Rescate (EIC Endpoint). Aprenderemos a entrar a nuestra instancia privada mediante EC2 Instance Connect (EIC) Endpoint. Olvídate de gestionar llaves .pem perdidas, de configurar un Bastion Host o de exponer tu servidor con una IP pública.
-
Misión 2: El Túnel de Objetos (S3 Gateway Endpoint). Configuraremos un acceso directo hacia Amazon S3. Veremos cómo podemos acceder a nuestros objetos sin que un solo paquete de datos toque la internet publica.
-
Misión 3: El Almacén de Datos (DynamoDB Gateway Endpoint). Estableceremos una conexión privada hacia nuestra base de datos NoSQL para asegurar que el tráfico de nuestra aplicación nunca salga de la red de AWS.
🛡️ Nota de Arquitecto: Aunque ambos son “Endpoints”, en las misiones 2 y 3 usaremos el tipo Gateway, que es un recurso gratuito y funciona mediante rutas en nuestra VPC, a diferencia del tipo Interface que usa direcciones IP privadas (ENI).
Misión 1: Rescate de la Instancia Privada (EIC Endpoint)
Si nos dirigimos a la consola de Amazon EC2, seleccionamos la instancia que desplegamos con nuestra plantilla de CloudFormation e intentamos conectarnos a ella utilizando el botón “Connect”, nos toparemos con un muro de advertencias:
“No public IPv4 or IPv6 address assigned.”
“Instance is not in a public subnet.”
AWS nos está confirmando que nuestra arquitectura de aislamiento funciona: la instancia no tiene “puertas” hacia el exterior. Tradicionalmente, aquí es donde muchos se rinden y crean un Bastion Host (un servidor extra que hay que pagar y parchar).
En resumidas cuentas, en este momento no podemos conectarnos a nuestra instancia. Pero no te preocupes, que para esto (y casi todo lo demás) existe… no, no es MasterCard 😉, es EC2 Instance Connect (EIC) Endpoint. Afortunadamente, contamos con esta funcionalidad que nos permite conectarnos a nuestros servidores en subredes privadas, incluso cuando están totalmente aislados del exterior.
Para configurarlo, sigamos estos pasos:
-
Dirígete al servicio de VPC en la consola de AWS.
-
En la columna de la izquierda, busca la sección PrivateLink and Lattice.
-
Selecciona Endpoints y luego haz clic en el botón Create endpoint.
🛠️ Configuración del Endpoint: El “Apretón de Manos”
Al crear el endpoint, nos encontraremos con varios campos. Vamos a desglosarlos para que no haya pérdida:
-
Name: EIC-Connect (o el que prefieras).
-
Type, Category: Selecciona EC2 Instance Connect Endpoint.
-
VPC: Elige nuestra VPC del workshop: Workshop-VPC-Endpoint.
⚠️ Un pequeño paréntesis: El Security Group del Endpoint
Antes de terminar, necesitamos un Security Group (SG) específico para nuestro EIC. Este actuará como el “permiso de salida” para que el túnel llegue a la instancia.
Crea un nuevo SG con estos datos:
-
Name: SG-EIC-Endpoint
-
VPC: Workshop-VPC-Endpoint
-
Outbound Rule (Regla de Salida): Es la única que necesitamos.
-
Protocolo: TCP
-
Puerto: 22 (SSH)
-
Destino: 10.0.0.0/25 (El CIDR de nuestra subred privada).
💡 Tip de Arquitecto: Usamos el CIDR 10.0.0.0/25 para que este endpoint nos sirva para cualquier instancia que lancemos en nuestra subred privada. Si quisiéramos ser ultra-estrictos (Zero Trust), en el Destino podríamos poner directamente el ID del Security Group de la instancia.
Listo! Con el Security Group creado, regresemos a la pestaña de creación del Endpoint:
-
En el apartado de Security groups, haz clic en el ícono de refrescar para que aparezca nuestro recién creado SG-EIC y selecciónalo.
-
En la sección de Subnet, selecciona la subred privada de nuestra VPC, asegúrate de que esté marcada la opción IPv4 y haz clic en Create endpoint.
La creación del recurso puede tomar un par de minutos. Mientras esperas, puedes tomar un café ☕. En cuanto veas el estado (Status) como Available, significa que nuestro túnel privado está listo para operar y conectarnos a la instancia.
A continuación, te dejo una imagen de referencia con la configuración completa del EIC Endpoint:

Misión 1: ¡Conexión Exitosa! 🚀
¡Llegó el momento de la verdad! Vamos a entrar a nuestra instancia privada sin necesidad de una IP pública:
-
Regresa al servicio de Amazon EC2 y selecciona tu instancia.
-
Haz clic en el botón Connect.
-
En las pestañas superiores, selecciona EC2 Instance Connect.
-
En la sección de Connection Type, elige la opción: Connect using a Private Ip (EC2 Instance Connect Endpoint).
-
En el menú desplegable de EC2 Instance Connect Endpoint, selecciona el Endpoint que creamos (EIC-Connect).
-
Finalmente, haz clic en Connect.

En este punto, ya deberíamos estar dentro de nuestro servidor EC2 sintiéndonos como auténticos hackers 💻. Ver ese prompt de la terminal después de haber pasado por una red 100% privada es la prueba de que nuestro túnel seguro funciona a la perfección.

Hasta este punto, no tenemos ninguna comunicación establecida con Amazon S3 ni con DynamoDB. Como nuestra instancia está en una subred privada sin salida a internet, ¿qué crees que pasaría si intentamos listar nuestros recursos desde la AWS CLI?
¡Hagamos la prueba de fuego! Ejecuta estos comandos en tu terminal:
# Intento de listar buckets
aws s3 ls

# Intento de listar tablas, pásale al comando la región en la que estas trabajando.
aws dynamodb list-tables --region us-east-2
¿Qué sucede? Exacto: Silencio total. La terminal se quedará “congelada” intentando alcanzar los endpoints públicos de AWS hasta que finalmente recibas un Connection Timeout.
💡 Explicación: Aunque los servicios de AWS son internos a la red de Amazon, sus APIs (los puntos a los que llamamos por CLI) residen en el internet público. Como nuestra instancia es “tímida” y no tiene salida al exterior, no sabe cómo llegar a ellos. De hecho, te invito a que revises la tabla de rutas “Tabla-Ruteo-Privada” creada por nuestro stack: notarás que no existe ninguna ruta (ni un Internet Gateway ni un NAT Gateway) que le indique al tráfico hacia dónde ir. Para nuestra instancia, el resto del mundo no existe… todavía.
Así que, para lograr nuestro objetivo de conectividad total sin comprometer la seguridad, vamos a implementar los Gateway Endpoints tanto para S3 como para DynamoDB.
Misión 2: Misión 2: El Túnel Privado para Amazon S3
Un Gateway Endpoint es, en esencia, un puente privado que creamos dentro de nuestra VPC para comunicarnos con los servicios de AWS sin que los datos salgan jamás de la red interna de Amazon. Es decir: logramos un contacto cero con el internet público.
A diferencia de otros tipos de endpoints, el de tipo Gateway no utiliza direcciones IP privadas en tu subred; en su lugar, funciona mediante “Prefix Lists” (listas de prefijos) que se añaden automáticamente a tu Tabla de Rutas.
💰 Dato para tu bolsillo: Los Gateway Endpoints para S3 y DynamoDB son gratuitos. No hay cargos por hora.
- Regresa al servicio de VPC y, en la columna izquierda, selecciona Endpoints seguido del botón “Create endpoint”.
- En Service category, asegúrate de que esté seleccionado AWS services.
- En la barra de búsqueda de Services, escribe: Gateway.
- ¡Punto Crucial! Busca el servicio que termina en .s3 y asegúrate de que el Type sea Gateway..
Nota: También verás uno de tipo “Interface”, pero esa es harina de otro costal (y tiene costo). Quédate con el Gateway, que es el héroe gratuito de esta historia.
-
En el desplegable de VPC, selecciona nuestra: Workshop-VPC-Endpoint.
-
Configuración de Red: Aquí debes marcar el check de nuestra Tabla-Ruteo-Privada.
¿Por qué? Al hacer esto, CloudFormation (o la consola) agregará automáticamente una ruta “mágica” que dice: “Todo el tráfico que vaya hacia S3, envíalo por este túnel privado”. Sin esto, tu instancia seguirá gritando al vacío.
- Para finalizar, haz clic en Create endpoint.


Esto puede tardar un par de minutos en aparecer como Available. Mientras tanto, ¡aprovechemos el tiempo!
Podemos adelantar la Misión 3: El Almacén de Datos (DynamoDB Gateway Endpoint) siguiendo exactamente los mismos pasos que acabamos de realizar. La única diferencia es que, en la barra de búsqueda de servicios, esta vez seleccionarás el que termina en .dynamodb (asegurándote de que el tipo sea Gateway).
No olvides asociarlo también a nuestra Tabla-Ruteo-Privada para que la magia de las rutas se aplique a ambos servicios.

Con nuestros Gateway Endpoints en estado Available, ha llegado el momento de volver a la terminal y reclamar nuestra victoria. Vamos a intentar listar de nuevo nuestro bucket de S3 y nuestra tabla de DynamoDB para confirmar que la comunicación fluye por el túnel privado:
🔍 Ahora puedes volver a nuestra Tabla-Ruteo-Privada y notarás que la magia ha sucedido: han aparecido dos nuevas rutas con identificadores que empiezan por pl-xxxxxxxx (Prefix Lists). Estas entradas apuntan directamente hacia S3 y DynamoDB.
Esas rutas son las que le indican a tu subred: “Si alguien pregunta por estos servicios, no busques en internet; envíalo por el túnel privado”. ¡El camino ya está despejado!
# Listar Buckets de S3
aws s3 ls

# Listar Tablas de DynamoDB, no olvides colocar tu región
aws dynamodb list-tables --region us-east-2


¡Yeahhh! 🚀 Si ves el nombre de tu bucket y de tu tabla en pantalla, ¡felicidades! Acabas de establecer una conexión privada, segura y, lo más importante, totalmente gratuita.
🧠 ¿Qué pasó tras bastidores? Cuando ejecutaste los comandos, tu VPC consultó la Tabla de Rutas, vio que el destino era S3/DynamoDB y, en lugar de intentar salir a internet, envió el tráfico directamente a través del Endpoint correspondiente para cada servicio. ¡Magia de redes en su máxima expresión!
¡Todo ha salido a la perfección! Ahora contamos con una arquitectura robusta y segura donde una instancia EC2, totalmente aislada en una subred privada y sin IP pública, puede comunicarse fluidamente con nuestros servicios de Amazon S3 y DynamoDB.
Partiendo de aquí, el cielo es el límite. Ustedes ya pueden realizar cualquier operación (subir archivos, consultar tablas, etc.) desde su instancia, siempre y cuando adjunten las políticas de IAM correctas al Role o Instance Profile que definimos en nuestro Stack inicial.
🧹 Limpieza: ¡No dejes la luz encendida!
Antes de irnos a celebrar nuestro éxito, es fundamental limpiar los recursos para mantener nuestra cuenta en $0 USD. Como mezclamos automatización con pasos manuales, el orden de eliminación es vital:
-
Elimina los Endpoints manualmente: Ve a la sección de Endpoints en la consola de VPC, selecciona los tres que creamos (S3, DynamoDB y EIC) y elígelos para eliminarlos. CloudFormation no puede borrar lo que él no creó.
-
Elimina el Security Group del EIC: Una vez borrado el endpoint, ve a Security Groups y elimina el SG-EIC-Endpoint.
-
Elimina el Stack de CloudFormation: Ahora sí, ve a la consola de CloudFormation, selecciona tu stack y dale a Delete. Esto borrará la EC2, la VPC y los roles automáticamente.
🏁 Conclusión
Dominar la conectividad privada es lo que separa a un administrador de nubes de un verdadero Arquitecto Cloud. Hoy demostramos que es posible construir una fortaleza segura, aislada y con un costo de red de $0, sin necesidad de NAT Gateways costosos para tareas simples.
Espero que este workshop te sirva para blindar tus arquitecturas y optimizar el presupuesto de tus proyectos.
¿Te quedó alguna duda sobre los tipos de Endpoints o la configuración de rutas? ¡Hablemos en los comentarios! 💬

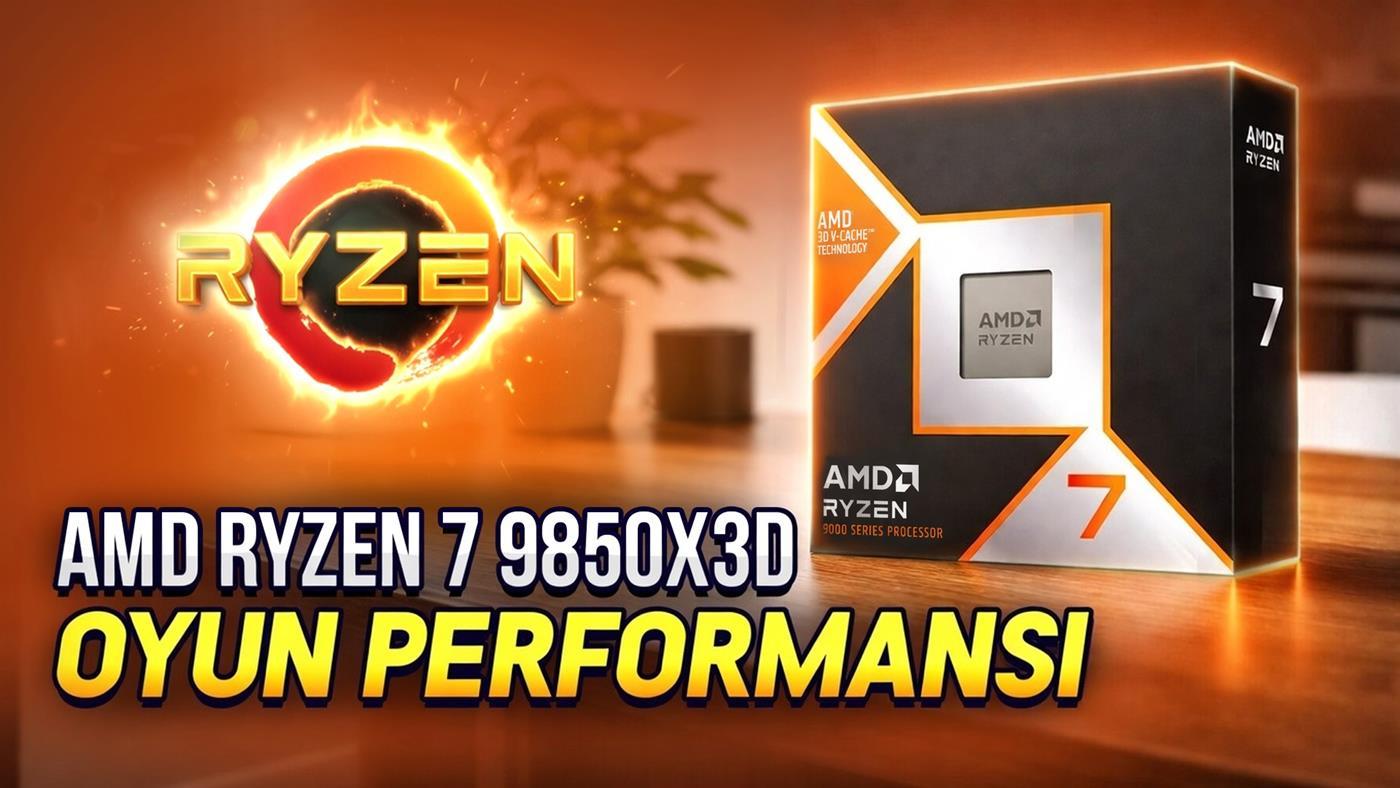
 AMD Ryzen 7 9850X3D, Zen 5 mimarisinin sunduğu performansı emsallerine göre devasa L3 önbellek teknolojisiyle birleştirerek oyunlarda ciddi bir performans artışı sağlıyor.
 Google, Translate uygulamasının canlı çeviri özelliğini iOS platformuna getirdi. iPhone kullanıcıları artık AirPods ve diğer kulaklıklarda gerçek zamanlı çeviri özelliğinden yararlanabiliyor.
 İngilizce Wikipedia, makale yazımı ve yeniden düzenleme süreçlerinde üretken yapay zeka kullanımını yasakladı. Peki bu kararın gerekçesi ne?
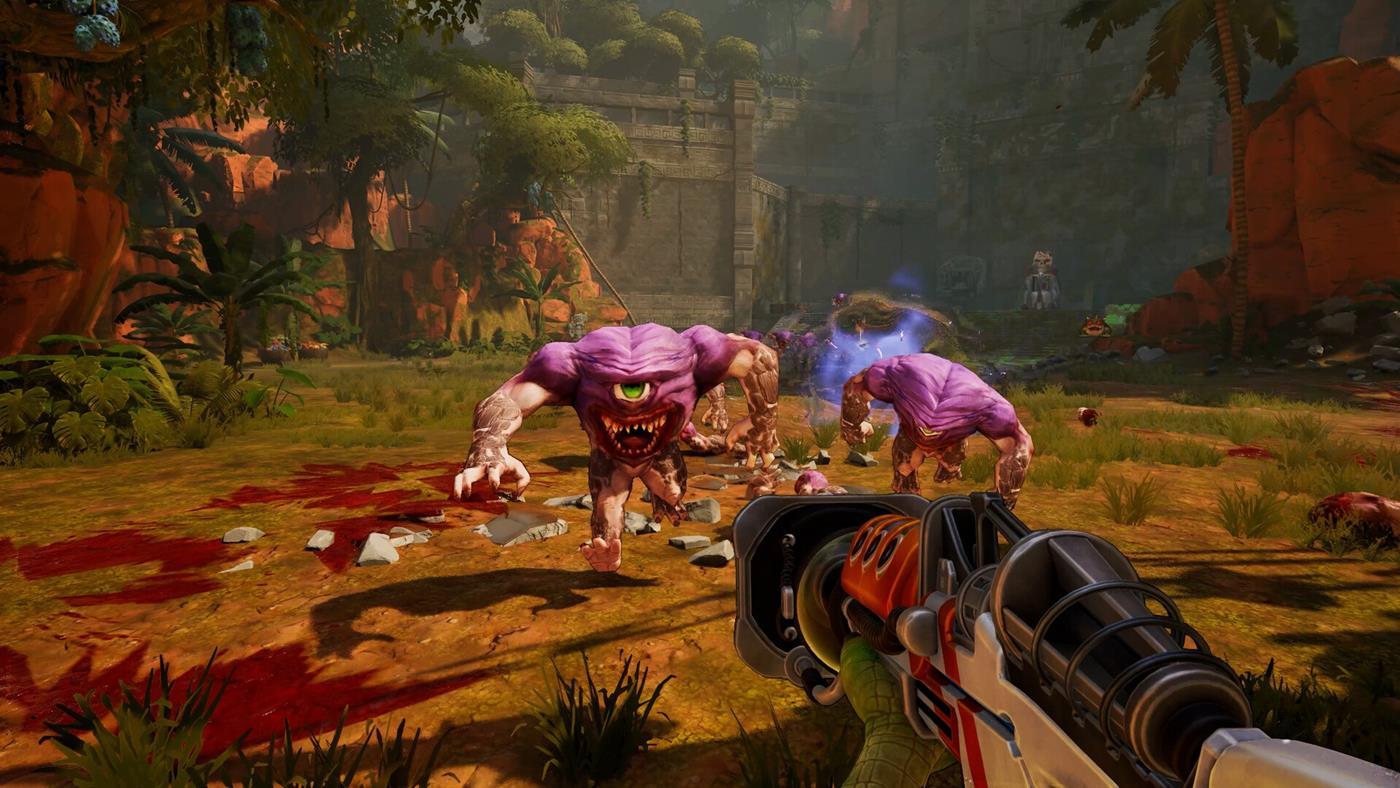
 Serious Sam: Shatterverse, çok oyunculu ve roguelite yapısıyla geri dönüyor. Farklı boyutlardan gelen Sam’ler, 2026 yılında PC, PlayStation 5 ve Xbox Series X|S platformlarında buluşacak.
